你一定遇到过这样的场景:公司积累了几年的产品手册、制度文件、会议纪要,新同事想查一条具体规则,翻半天找不到;想让 AI 帮忙回答,它却一本正经地编一个答案。问题不在 AI「不聪明」,而在于它不知道你的私有资料。RAG(检索增强生成)就是解决这个问题的标准方案——这个词在 AI 行业出现的频率仅次于大模型本身,但真正讲清楚它的人不多。
一、定义:RAG 是让大模型「开卷考试」
RAG 的全称是 Retrieval-Augmented Generation(检索增强生成)。它的核心思路一句话就能说清:
先从你的知识库中检索出与问题最相关的内容,再把「这些内容 + 用户的问题」一起交给大模型,让模型基于这些材料组织答案。
用考试来比喻:普通大模型是「闭卷考试」,只能靠训练时记住的东西答题,记错了、记漏了就胡说(这就是「幻觉」);RAG 是「开卷考试」——答题前先翻资料,答案有出处、可核查。没有 RAG,模型只知道训练数据里的旧知识;有了 RAG,它能用上你私有的、最新的数据。
行业里的 ACM RAG 综述把它定义为「将 LLM 输出锚定在可验证证据上的主流策略」——关键词是可验证:答案不再凭空而来,而是有据可查。
二、工作流程:四个环节,一条流水线
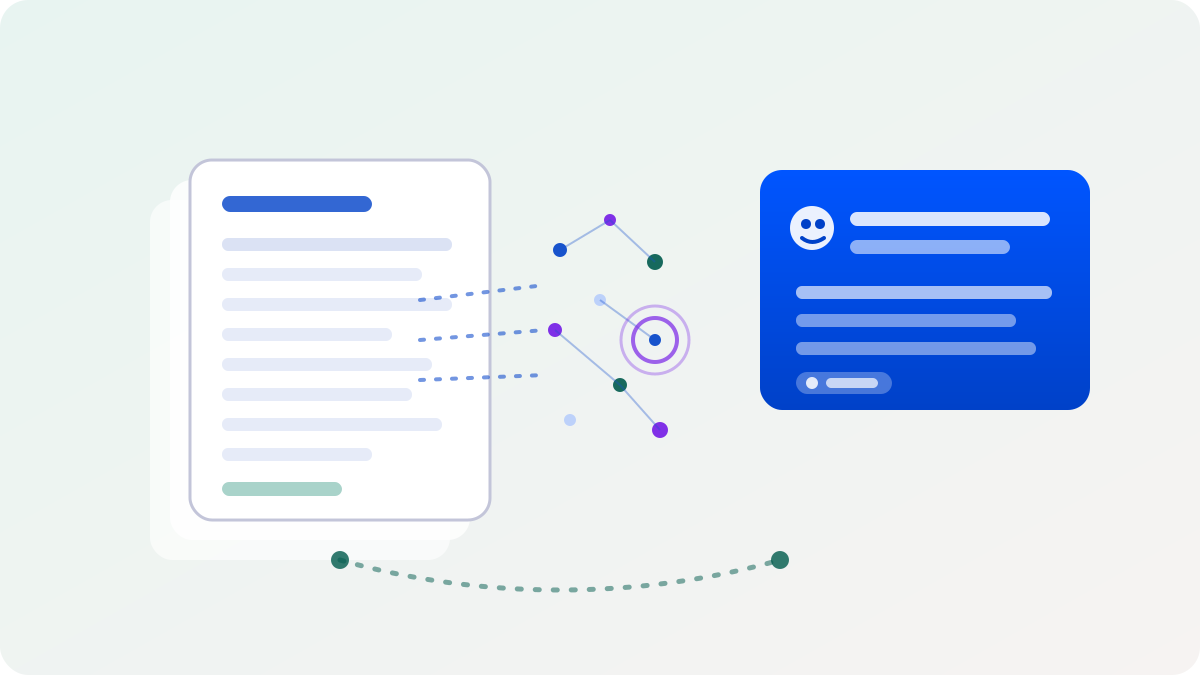
工程上,现代 RAG 架构可以拆解为四个阶段:索引(Indexing)→ 检索(Retrieval)→ 融合(Fusion)→ 生成(Generation)。理解这条流水线,你就理解了 RAG 系统的全部关键工程点:
文档先经过清洗与切分(切成小片段),再由嵌入模型(Embedding)把它们编码成向量存入向量数据库。Embedding 把文字变成可比较的坐标,向量索引则支撑从海量内容中快速找出候选片段。
用户提问后,问题同样被向量化,在知识库中按语义相似度召回最相关的若干片段——注意是「语义」,你问「报销上限」,它能找到写着「费用额度上限」的段落,而不是靠关键字硬匹配。
召回的片段可能有冗余、有冲突,需要重新排序、去除重复、与原始问题做语义对齐,选出最有价值的几段作为「证据包」。
把证据包与问题一起交给大模型,要求它「只基于给定材料回答,并标注来源」。这样输出的答案可追溯、会引用,出现争议时能回到原文定位。
三、为什么企业需要 RAG:三个硬问题
企业知识问答有两类需求:一类是查「制度怎么说」的静态知识,一类是查「我的报销审批到哪一步了」的实时业务状态。前者靠 RAG 检索文档,后者靠对接业务系统——而两者都建立在一个共识上:企业资料需要变成可检索、可授权、可引用的回答依据。RAG 解决的正是三个绕不开的硬问题:
所有大模型都有知识截止日期,训练数据之后发生的事它一无所知。RAG 接的是实时更新的知识库,制度改了、价格变了,更新索引即可生效,无需重新训练模型。
公司内部的规范、工单记录、产品文档,从来不在公开训练数据里。RAG 不改动模型本身,而是把私有知识「外挂」进来——这也是数据合规上更稳妥的路径。
企业内部问答最怕「看起来对」的幻觉。RAG 生成的每个结论都能标注来源段落,既方便人工复核,也能设置权限——谁能看到哪些知识,由知识库的授权体系决定。
把几百页文档整体塞进模型的上下文,既装不下也不经济。RAG 每次只取最相关的少量片段,响应速度和调用成本都是量级上的优化。
四、RAG 的进化:从「基础检索」到「智能体化」
RAG 本身也在快速迭代。技术社区里常把它分为三代:第一代是模块化基础架构(切块 + 向量检索 + 拼接生成),解决了「能用」问题;第二代引入图增强推理(GraphRAG),用知识图谱处理「多跳关系」类问题,比如跨部门规章之间的推导;第三代是智能体化(Agentic RAG)——让智能体自主决定「要不要检索、检索什么、要不要换个问法再查一次」,把检索从固定流程变成自主决策。
线上一线团队的经验是:不要一步追求最新架构,先看自己的问题属于哪一类——简单事实查询用基础 RAG 就够,关系推理类问题才需要 GraphRAG,多源复杂任务才轮到 Agentic RAG。方案匹配场景,比追新更省钱。
五、三个常见误区
- 「RAG 就是企业网盘加个搜索」:RAG 不等于把资料堆起来,它需要切分策略、向量化、排序融合一整套工程;网盘解决「存」的问题,RAG 解决「用」的问题;
- 「有了 RAG 就不用整理知识」:恰恰相反,知识库质量决定 RAG 的效果上限。重复文档、过期制度、口径冲突会直接污染回答。成熟做法是配套冲突检测、人工审核、版本管理与灰度发布;
- 「RAG 和微调二选一」:两者分工不同——RAG 管「知道企业的事实」(更新快、可溯源),微调管「像行业专家一样表达」(成本高、更新慢)。多数场景先 RAG、后微调,组合使用。
常见问题
Q1:RAG 和把资料直接粘贴给 AI 有什么区别?
把整本书或全部文档贴给 AI,上下文窗口装不下、成本高,而且每次对话都要重复处理。RAG 的做法是先建索引,提问时只检索最相关的少量片段再交给模型:成本可控、响应更快、答案可标注来源,知识更新时只需更新索引。
Q2:有了 RAG,是不是就不需要整理知识库了?
恰恰相反。RAG 的效果上限由知识库质量决定:文档切分策略、元数据标注、重复与冲突内容的治理、更新审核流程,都会直接影响回答质量。行业里的说法是「垃圾进、垃圾出」——RAG 是放大器,不是清洁工。
Q3:RAG 和模型微调(Fine-tuning)应该怎么选?
分工不同:知识更新用 RAG,风格与能力用微调。RAG 负责让模型「知道企业的最新事实」,可溯源、更新快;微调负责让模型「更像行业专家地表达」,成本更高、更新较慢。多数企业场景两者组合使用,先 RAG、后微调是更稳妥的路径。
RAG 让模型「知道」,AI Agent(智能体)让模型「会做」,Agent Skills(智能体技能)让模型「做得规范」。它们与 LLM、企业内部产品的层级与关联,可读总纲《LLM、RAG、Skill、Agent、内部产品:五个概念的关系一篇讲清》;想直接看落地路径,可以参考《企业 AI 落地 SOP》。